Plik robots.txt: co to jest, przykłady, tester i boty AI
Składnia, gotowe wzory dla WordPressa, PrestaShop i Shopera oraz reguły dla GPTBot, Google-Extended i ClaudeBot
- gotowe przykłady
- raport w Search Console
- wycena audytu w 24 h
Robots.txt to plik tekstowy w głównym katalogu domeny, pod adresem twojafirma.pl/robots.txt, w którym zapisujesz, których adresów roboty wyszukiwarek i boty AI nie powinny pobierać. Plik steruje skanowaniem, a nie indeksowaniem: zablokowana strona może nadal być w Google, więc do usuwania z wyników służy noindex. Poniżej znajdziesz składnię, przykłady, tester w Search Console i reguły dla botów AI. Plik robots.txt sprawdzamy w każdym audycie SEO Backlink24 od 1 229 zł brutto.
16 latdoświadczenia w SEO
400+obsłużonych stron i serwisów
Spis treści22 sekcje
- W skrócie
- Usługi i ceny
- Case study i opinie
- Co sprawdzamy
- Jak pracujemy
- Robots.txt: co to jest
- Gdzie jest plik robots.txt
- Składnia i reguły
- Robots.txt: przykłady
- Robots.txt w WordPress
- PrestaShop i Shoper
- Noindex a Disallow
- Sitemap w robots.txt
- Tester robots.txt w Search Console
- Boty AI w robots.txt
- Najczęstsze błędy
- Robots.txt a pozycje
- Ile to kosztuje
- Powiązane usługi
- FAQ
- Kontakt
- Autor strony

Sprawdzimy, czy robots.txt nie blokuje ważnych stron
Podaj adres strony. Odpowiadamy w ciągu jednego dnia roboczego, z listą problemów i ceną poprawek. Bez zobowiązań.
Zostaw adres strony, a sprawdzimy, czy robots.txt nie odcina Google od ważnych podstron
Odpowiadamy w ciągu jednego dnia roboczego, z listą problemów i ceną poprawek. Bez zobowiązań.
W skrócie
- Robots.txt leży zawsze w katalogu głównym domeny i działa tylko dla tego hosta, protokołu i portu. Subdomena sklep.twojafirma.pl potrzebuje własnego pliku.
- Google obsługuje cztery pola: user-agent, allow, disallow i sitemap. Crawl-delay i noindex w tym pliku Google ignoruje.
- Disallow nie usuwa strony z wyników. Do tego służy noindex albo kod 404 lub 410, a strona musi pozostać dostępna dla robota, żeby Google zobaczył noindex.
- Tester robots.txt w Search Console zastąpiono raportem robots.txt w Ustawieniach usługi. Boty AI blokujesz osobnymi grupami, na przykład dla GPTBot, ClaudeBot i Google-Extended.
16 latdoświadczenia w SEO
Regułysprawdzone na żywych adresach
Raportz listą zmian do wdrożenia
Krakówbiuro, obsługa w całej Polsce
Pomoc z plikiem robots.txt: usługi i ceny
Prosty plik dla strony firmowej poprawisz sam w kwadrans, korzystając z przykładów niżej. Gdy sklep ma filtry, wersje językowe albo spadki w raporcie indeksowania, robots.txt sprawdzamy razem z resztą techniki w audycie, a poprawki wdrażamy jednorazowo lub w stałej opiece SEO.
Audyt SEO
gdy chcesz wiedzieć, co blokuje stronę
od 1 229 złbrutto · zależnie od wielkości strony
- analiza robots.txt na każdej subdomenie
- metatagi robots i X-Robots-Tag
- lista adresów zablokowanych przez pomyłkę
Jednorazowa optymalizacja
wdrożenie poprawek na stronie
od 3 690 złbrutto · jednorazowo
- nowy robots.txt dopasowany do CMS
- noindex tam, gdzie powinien być
- reguły dla botów AI według Twojej decyzji
Pozycjonowanie strony
technika pod stałą kontrolą
od 1 190 złbrutto / mies. · pakiety SEO
- kontrola raportu robots.txt co miesiąc
- reakcja na zmiany po aktualizacjach CMS
- raport z wykonanymi pracami
Ceny aktualne na 11 listopada 2026. Ceny brutto (zawierają 23% VAT). Audyt od 1 229 zł brutto (999 zł netto), optymalizacja od 3 690 zł brutto (3 000 zł netto). Pozycjonowanie: pakiety 1 190, 1 790, 2 490 i 2 990 zł brutto miesięcznie, czas nieokreślony, 1 miesiąc wypowiedzenia.
Search Console pokazuje „Zablokowano przez plik robots.txt”? Napisz, co widzisz
Wklej adres strony i przykładowe adresy z raportu. Sprawdzimy, która reguła je blokuje, czy blokada jest celowa i co zmienić, żeby nie odciąć Google od stron, które mają sprzedawać.
Jedna linijka w robots.txt potrafi wyłączyć cały sklep
Najgroźniejsze błędy w robots.txt są krótkie: zostawione po wdrożeniu Disallow: /, blokada katalogu z plikami CSS albo reguła, która przy okazji łapie kategorie. Dlatego plik czytamy razem z listą adresów, które mają zarabiać, a nie w oderwaniu od strony.
- Reguły na prawdziwych adresach
Każdą regułę przykładamy do adresów kategorii, produktów i wpisów, a nie tylko do wzoru z dokumentacji.
- Plik i metatagi razem
Sprawdzamy, czy strony z noindex nie są przy okazji zablokowane, bo wtedy Google noindexu nie zobaczy.
- Boty AI świadomie
Pokazujemy, który bot służy do treningu, a który do wyszukiwania, żeby blokada nie odcięła Cię od cytowań.
- Kontrola po zmianie
Po wdrożeniu sprawdzamy raport robots.txt i raport indeksowania stron w Search Console.
Case study: od zera do 100 000 wejść miesięcznie
Case study w liczbach. MamyRecepte.pl: 90 tys. wejść miesięcznie i 346 fraz w TOP 1-3. Randkujmy: 100 tys. wejść i 1 300 fraz w TOP 1-3. Eurofance.pl: +10 tys. wejść i 400 fraz w TOP 1-3.

MamyRecepte.pl: od zera do 90 000 wejść miesięcznie
Serwis z receptami online w branży, w której Google ocenia treści najsurowiej. Dziś jest na pierwszej stronie obok NFZ i dużych platform medycznych, a ChatGPT, Perplexity i Google AI cytują go jako źródło.


Randkujmy: od zera do 100 000 wejść miesięcznie
Domena bez historii, bez linków i bez ruchu w jednej z najbardziej konkurencyjnych nisz w Polsce. Dziś jest w czołówce na „portal randkowy” i na setki fraz lokalnych „randki + miasto”.


Eurofance.pl: +10 000 wejść miesięcznie po spadku
Projekt startował ze spadkami po aktualizacji algorytmu Google, strona straciła widoczność. Przemodelowaliśmy strategię od podstaw: optymalizacja techniczna i treści, linki z mocnych portali i stała praca nad podstronami przywróciły ruch organiczny i wyraźnie go zwiększyły.
Więcej case study: sklep z sukienkami (9 500 fraz w TOP 1-3), sklep z winem, sklep medyczny i inne
Co mówią nasi klienci
BackLink24 wyróżnia się spośród wszystkich firm, z którymi współpracowaliśmy do tej pory. Bardzo ważna jest dla nas terminowość i rzetelność wykonywanych działań. Kładziemy ogromny nacisk na jakość tego, co robimy i dlatego też chcemy współpracować tylko z najlepszymi partnerami. BackLink24 spełnia nasze oczekiwania w tym zakresie. Współpraca rozpoczęła się od propozycji ciekawych i co najważniejsze skutecznych strategii a dzisiaj możemy śmiało stwierdzić, że efekty tych działań przerosły nasze oczekiwania.
Jesteśmy zadowoleni zarówno z jakości pozyskiwanych linków, jak i z komunikacji z firmą. Zespół BackLink24 jest w stanie podołać każdemu zadaniu. Nawet takiemu, które na pierwszy rzut oka wydaje się niemożliwe. To dla nas bardzo ważne, bo wysokie pozycje zapewniają nam wzrost liczby klientów. Co tu dużo mówić, jeżeli dobrze to tylko w BackLink24 :).
Serdecznie polecam usługi BackLink24. Na plus zarówno kontakt, jak i podejście do klienta. Mogę dzwonić w każdej chwili i zawsze mam gwarancję, że zajmą się moją sprawą. W branży SEO takie detale są naprawdę bardzo ważne. Często jest tak, że potrzebuje czegoś „na już”, a w tym przypadku zawsze mogę liczyć na wsparcie.
Od dłuższego czasu regularnie współpracujemy z Backlink24.pl, doceniając ich przemyślane podejście do budowania profilu linkowego. Wysoka jakość publikacji, przejrzystość działań oraz zauważalne efekty w postaci poprawy widoczności strony sprawiają, że jest to partner, któremu warto zaufać. Profesjonalizm zespołu i dobra komunikacja czynią Backlink24.pl ważnym elementem naszych działań SEO.


MamyRecepte.pl: od zera do 90 000 wejść miesięcznie
Serwis z receptami online w branży, w której Google ocenia treści najsurowiej, a konkurencją są duże podmioty medyczne z wieloletnim autorytetem. Dziś MamyRecepte.pl ma 90 000 wejść miesięcznie wyłącznie z wyników organicznych i jest cytowany przez modele AI.
Najważniejsze frazy
| Fraza | Pozycja w Google |
|---|---|
| recepta online | TOP 4-5 |
| recepta | TOP 5 |
| antybiotyk na anginę | TOP 5 |
| e-recepta | TOP 6 |
| antybiotyk 3 dniowy | TOP 6 |
| recepty online | TOP 6 |
Frazy w pozycjach 1-3
Frazy w pozycjach 4-10

Cytowania w modelach AI
Co zrobiliśmy
- Strategia pod branżę medycznąanaliza konkurencji i rynku, nacisk na E-E-A-T i zaufanie domeny
- Optymalizacja techniczna i treścistruktura serwisu, szybkość, dane strukturalne, jakość tekstów
- Treści na poziomie eksperckimmerytoryczne odpowiedzi na realne pytania pacjentów
- Linki z wiarygodnych źródełtematycznie powiązane publikacje, ważne w branży zdrowotnej
Randkujmy: od zera do 100 000 wejść miesięcznie
Portal randkowy startował bez historii domeny, bez linków i bez ruchu, w niszy zdominowanej przez marki z wieloletnią przewagą. Dziś zajmuje czołowe pozycje na „portal randkowy” i „portale randkowe” oraz na setki fraz lokalnych w całym kraju.
Najważniejsze frazy
| Fraza | Pozycja w Google |
|---|---|
| portal randkowy | TOP 1-2 |
| portale randkowe | TOP 2 |
| randki | TOP 5 |
| ogłoszenia towarzyskie | TOP 10 |
Do tego setki fraz lokalnych, m.in. randki Warszawa, randki Kraków, randki Wrocław, portal randkowy Poznań.
Frazy w pozycjach 1-3
Frazy w pozycjach 4-10
Co zrobiliśmy
- Pełna optymalizacja platformyszybkość, adresy URL, dane strukturalne, indeksacja, Core Web Vitals
- Ciągła rozbudowa treścifrazy ogólne, długi ogon i setki fraz lokalnych
- Poprawa UX i zaangażowaniamniej odrzuceń, dłuższe sesje, chętniejsze powroty
- Pozyskiwanie linkówprowadzone równolegle i bez przerwy przez cały czas współpracy
Co sprawdzamy w robots.txt podczas audytu SEO?
Plik robots.txt oceniamy jako część technicznego SEO. Liczy się nie to, czy plik istnieje, tylko czy pozwala Google dotrzeć do stron, które mają sprzedawać, i trzyma roboty z dala od miejsc, które tylko marnują ich czas.
- Dostępność pliku
Kod odpowiedzi, przekierowania, rozmiar i wersje dla każdej subdomeny oraz protokołu.
- Składnia i kolejność grup
Literówki w polach, puste Disallow, grupy, które się wykluczają, i reguły z błędną wielkością liter.
- Filtry i parametry w sklepie
Czy sortowanie, wyszukiwarka wewnętrzna i koszyk są zamknięte, a kategorie i produkty otwarte.
- Zasoby do renderowania
Czy Google może pobrać pliki CSS, JavaScript i obrazy potrzebne do wyświetlenia strony.
- Reguły dla botów AI
Które boty są zablokowane, jakie ma to skutki i czy zgadza się z tym, co chcesz osiągnąć.
- Mapa witryny
Czy linia Sitemap wskazuje działającą mapę i czy w mapie nie ma adresów zablokowanych w pliku.
Jak poprawiamy plik robots.txt krok po kroku
Najpierw ustalamy, co Google dziś widzi, potem piszemy plik pod konkretną platformę, a na końcu sprawdzamy, czy zmiana nie zablokowała niczego wartościowego.
Diagnoza
Czytamy obecny plik, raport robots.txt i raport indeksowania stron, a do tego crawlujemy stronę jak Googlebot.
na startNowy plik
Przygotowujemy reguły pod CMS i strukturę adresów, z komentarzem przy każdej linii, żeby wiadomo było, po co jest.
wdrożenieKontrola
Testujemy adresy w narzędziu do sprawdzania URL, prosimy o odświeżenie pliku i obserwujemy raporty przez kolejne tygodnie.
po wdrożeniu
Robots.txt: co to jest i do czego służy plik robots?
Robots.txt to plik tekstowy zapisany w kodowaniu UTF-8, który publikujesz w katalogu głównym domeny. Robot wyszukiwarki, zanim pobierze jakąkolwiek podstronę, najpierw zagląda pod adres /robots.txt i sprawdza, czy właściciel nie wyłączył części serwisu. Zasady pliku opisuje Robots Exclusion Protocol, który od 2022 roku jest standardem IETF (RFC 9309).
Plik robots służy przede wszystkim do zarządzania ruchem robotów. Dzięki niemu Googlebot nie traci czasu na wyniki wyszukiwarki wewnętrznej, tysiące kombinacji filtrów, koszyk czy panel administracyjny i szybciej dociera do kategorii, produktów i artykułów. W dużych sklepach ma to wpływ na to, jak szybko nowe produkty trafiają do Google.
Trzeba pamiętać o dwóch ograniczeniach. Po pierwsze, reguły są prośbą, a nie zabezpieczeniem: Googlebot i Bingbot ich przestrzegają, ale złośliwy skrypt zrobi, co zechce, a sam plik jest publiczny i pokazuje, co próbujesz ukryć. Po drugie, robots.txt steruje skanowaniem, a nie indeksowaniem. O tym, jak Google pobiera i ocenia strony, piszemy szerzej na stronie techniczne SEO.
Gdzie jest plik robots.txt i jak go utworzyć?
Plik robots.txt musi leżeć w katalogu głównym hosta, czyli pod adresem https://twojafirma.pl/robots.txt. Kopia w podkatalogu nie działa. Własny plik potrzebuje każda subdomena, każdy protokół i każdy niestandardowy port.
- 1Sprawdź, czy plik już jest
Wpisz w przeglądarce adres domeny z dopiskiem /robots.txt. Większość CMS tworzy plik automatycznie, czasem wirtualnie, bez fizycznego pliku na serwerze.
- 2Utwórz plik w edytorze tekstu
Wystarczy Notatnik lub dowolny edytor kodu. Zapisz plik jako robots.txt, małymi literami, w kodowaniu UTF-8. Nie używaj edytora tekstu biurowego, bo dodaje formatowanie.
- 3Wgraj go do katalogu głównego
Przez FTP lub menedżer plików w panelu hostingu do tego samego katalogu, w którym jest plik index strony. W CMS skorzystaj z edytora we wtyczce lub module SEO.
- 4Sprawdź kod odpowiedzi
Plik powinien zwracać kod 200. Kod 404 oznacza dla Google brak ograniczeń, a błąd serwera 5xx wstrzymuje skanowanie całej strony.
- 5Odśwież plik w Search Console
Po ważnej zmianie poproś o ponowne pobranie w raporcie robots.txt. Google zwykle trzyma kopię pliku do 24 godzin.
Według dokumentacji Google Search Central (stan na listopad 2026) Google czyta pierwsze 500 KiB pliku, a resztę pomija. Przy błędzie 5xx przez pierwsze 12 godzin wstrzymuje skanowanie, a potem przez 30 dni korzysta z ostatniej dobrej kopii pliku.
Składnia robots.txt: user-agent, disallow, allow i sitemap
Plik składa się z grup. Każda grupa zaczyna się od jednej lub kilku linii User-agent, po których są reguły Disallow i Allow. Google obsługuje cztery pola: user-agent, allow, disallow i sitemap. Nazwy pól mogą mieć dowolną wielkość liter, ale ścieżki już nie.
| Element | Co robi | Przykład |
|---|---|---|
| User-agent | wskazuje robota, którego dotyczy grupa | User-agent: Googlebot |
| User-agent: * | wszystkie roboty bez własnej grupy w pliku | User-agent: * |
| Disallow | blokuje adresy zaczynające się od ścieżki | Disallow: /koszyk/ |
| Allow | otwiera adres wewnątrz zablokowanego katalogu | Allow: /wp-admin/admin-ajax.php |
| Sitemap | pełny adres mapy witryny, niezależny od grup | Sitemap: https://twojafirma.pl/sitemap.xml |
| * w ścieżce | dowolny ciąg znaków | Disallow: /*?sort= |
| $ na końcu | koniec adresu | Disallow: /*.pdf$ |
| # | komentarz, robot go pomija | # blokada wyszukiwarki |
| Crawl-delay | Google ignoruje, część innych robotów respektuje | Crawl-delay: 10 |
Która reguła wygrywa, gdy kilka pasuje do adresu?
Google stosuje regułę najbardziej szczegółową, czyli z najdłuższą ścieżką. Gdy dwie reguły są równie długie, a jedna blokuje, a druga pozwala, wygrywa mniej restrykcyjna, czyli Allow. Każdy robot korzysta tylko z jednej grupy: tej, która najdokładniej pasuje do jego nazwy. Jeśli w pliku jest grupa dla Googlebota, Googlebot pomija grupę z gwiazdką, więc wspólne zakazy trzeba w niej powtórzyć.
Robots txt * i wielkość liter
Gwiazdka w linii User-agent oznacza wszystkie roboty, a w ścieżce dowolny ciąg znaków. Gwiazdka na końcu ścieżki nic nie zmienia, bo reguły i tak działają jak prefiks. Ścieżki rozróżniają wielkość liter: Disallow: /Admin/ nie zablokuje katalogu /admin/. Pusta reguła Disallow: bez ścieżki niczego nie blokuje.
Robots.txt przykład: gotowe wzory dla typowych sytuacji
Poniższe przykłady to punkt wyjścia. Zanim wkleisz którykolwiek, porównaj ścieżki z adresami na swojej stronie, bo ten sam katalog w jednym CMS jest panelem, a w innym kategorią produktów. Pierwszy przykład to plik, który niczego nie blokuje i tylko wskazuje mapę witryny. Dla małej strony firmowej to często w zupełności wystarczy:
User-agent: *
Disallow:

Sitemap: https://twojafirma.pl/sitemap.xml
Drugi przykład zamyka wyszukiwarkę wewnętrzną, sortowanie i koszyk w sklepie, ale zostawia kategorie i produkty otwarte. Parametry w adresach są najczęstszym źródłem tysięcy zbędnych podstron:
User-agent: *
Disallow: /szukaj
Disallow: /koszyk
Disallow: /zamowienie
Disallow: /moje-konto
Disallow: /*?sort=
Disallow: /*?order=
Disallow: /*&sort=

Sitemap: https://twojsklep.pl/sitemap.xml
Trzeci przykład blokuje całą stronę testową na subdomenie. Taki plik jest w porządku na środowisku testowym, ale to on najczęściej trafia przez pomyłkę na produkcję przy wdrożeniu nowej wersji strony. Lepszym zabezpieczeniem kopii testowej jest hasło, bo plik nie chroni przed wejściem.
# tylko na test.twojafirma.pl, nigdy na produkcji
User-agent: *
Disallow: /
Czwarty przykład pokazuje regułę z wyjątkiem: katalog z plikami do pobrania jest zamknięty, ale jeden cennik w PDF ma zostać widoczny w Google.
User-agent: *
Disallow: /pliki/
Allow: /pliki/cennik.pdfPlik robots.txt w WordPress: gdzie jest i jak go zmienić?
WordPress nie zapisuje pliku na serwerze. Generuje go w locie, gdy robot pyta o /robots.txt, dlatego w menedżerze plików go nie znajdziesz. Domyślna wersja wygląda tak i jest rozsądna dla większości stron:
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://twojafirma.pl/wp-sitemap.xml
Linia z admin-ajax.php jest ważna, bo przez ten plik wiele motywów i wtyczek ładuje treść. Linię Sitemap WordPress dodaje sam od wersji 5.5, wskazując wbudowaną mapę. Jeśli korzystasz z Yoast SEO, mapa ma adres sitemap_index.xml i warto podmienić ją w pliku.
Plik robots.txt w WordPress zmienisz na trzy sposoby. W Yoast SEO edytor jest w narzędziach wtyczki, w module edytora plików. W Rank Math znajdziesz go w ustawieniach ogólnych. Trzecia droga to wgranie własnego pliku robots.txt przez FTP do katalogu głównego: fizyczny plik ma pierwszeństwo przed wirtualnym, więc ustawienia we wtyczce przestają wtedy działać, o czym łatwo zapomnieć.
Częsty błąd na WordPressie to zaznaczona opcja „Proś wyszukiwarki o nieindeksowanie tej witryny” w ustawieniach czytania, zostawiona po budowie strony. W nowszych wersjach dodaje ona metatag noindex, a w starszych także blokadę w pliku. Opiekę techniczną nad takimi stronami opisujemy na stronie pozycjonowanie WordPress.
Robots.txt w PrestaShop i Shoper: co blokować w sklepie?
W sklepie robots.txt ma jedno główne zadanie: zamknąć adresy, które powstają z filtrów, sortowania, wyszukiwarki i procesu zamówienia, a zostawić otwarte kategorie, produkty i bloga. Platformy generują plik same, ale nie znają Twoich filtrów ani modułów.
| Platforma | Skąd bierze się plik | Na co uważać |
|---|---|---|
| PrestaShop 1.7 i 8 | generowany w panelu: Parametry sklepu, Ruch i SEO, sekcja generowania pliku robots.txt | ponowne wygenerowanie nadpisuje ręczne zmiany |
| Moduły filtrów w PrestaShop | dodają własne parametry w adresach | parametry filtrów trzeba dopisać ręcznie |
| Shoper | plik tworzy platforma, ustawienia SEO są w Ustawienia, Zaawansowane, SEO | zakres ręcznej edycji zależy od wersji sklepu |
| WooCommerce | wirtualny plik WordPressa lub wtyczka SEO | koszyk i konto bywają otwarte dla robotów |
Robots txt w PrestaShop po wygenerowaniu zawiera kilkadziesiąt linii, między innymi blokady koszyka, logowania, zamówień i parametrów w adresach. To dobra baza, ale przy każdej zmianie modułów warto plik przejrzeć, bo ponowne wygenerowanie usuwa reguły dopisane ręcznie. Dlatego własne linie trzymamy w osobnym bloku z komentarzem i kopią poza serwerem. Więcej o technice tej platformy na stronach optymalizacja PrestaShop i pozycjonowanie PrestaShop.
W Shoperze plik przygotowuje platforma, a właściciel sklepu ma wpływ przede wszystkim na ustawienia SEO i przyjazne adresy. Zanim zaczniesz szukać sposobu na ręczną edycję, sprawdź w raporcie robots.txt w Search Console, co plik faktycznie blokuje, a w razie wątpliwości zapytaj pomoc techniczną Shopera. Specyfikę tej platformy opisujemy na stronie pozycjonowanie Shoper.
Nie wiesz, czy Twój sklep blokuje filtry, czy kategorie? Wyślij adres, sprawdzimy plik na żywych adresach.
Sprawdźcie mój sklepRobot txt no index: czym różni się noindex od Disallow?
Disallow mówi robotowi: nie pobieraj tej strony. Noindex mówi: możesz pobrać, ale nie pokazuj jej w wynikach. Jeśli zablokujesz w robots.txt stronę z noindex, Google nie odczyta metatagu i adres może zostać w indeksie, zwykle bez opisu.
| Cel | Czego użyć | Czego nie robić |
|---|---|---|
| strona ma zniknąć z wyników Google | metatag robots noindex lub nagłówek X-Robots-Tag | nie blokuj jej jednocześnie w robots.txt |
| strona usunięta na stałe | kod 404 lub 410 | nie przekierowuj wszystkiego na stronę główną |
| roboty nie mają tracić czasu na filtry i sortowanie | Disallow w robots.txt | nie dodawaj noindex do tysięcy adresów, które i tak są pobierane |
| plik PDF lub obraz poza wynikami | X-Robots-Tag: noindex w nagłówku HTTP | metatag nie zadziała, bo PDF nie ma sekcji head |
| poufne dane | hasło lub logowanie | robots.txt jest publiczny i nie chroni przed wejściem |
Robot no index w kodzie strony wygląda tak: <meta name="robots" content="noindex"> w sekcji head. Dla plików bez HTML, na przykład PDF, ten sam efekt daje nagłówek HTTP ustawiony na serwerze. Wpis noindex w samym pliku robots.txt nie działa: Google przestał go obsługiwać we wrześniu 2019 roku, a w aktualnej dokumentacji wymienia tylko cztery obsługiwane pola.
<meta name="robots" content="noindex, follow">

X-Robots-Tag: noindex
Jeśli Twoim celem jest szybkie ukrycie konkretnego adresu w wynikach, a nie zarządzanie robotami, opisujemy to krok po kroku na stronie o indeksowaniu. Na tej stronie zostajemy przy pliku robots.txt.
Sitemap w robots.txt: jak wskazać mapę witryny?
Linia Sitemap w robots.txt podaje robotom pełny adres mapy witryny XML. Możesz ją umieścić w dowolnym miejscu pliku, nie należy do żadnej grupy User-agent i może wystąpić wiele razy, na przykład osobno dla mapy produktów i mapy wpisów. Adres musi być pełny, z protokołem i domeną.
Sitemap: https://twojsklep.pl/sitemap_index.xml
Sitemap: https://twojsklep.pl/sitemap-produkty.xml
Sitemap robots txt to wygodna droga, bo każda wyszukiwarka, nie tylko Google, znajdzie mapę bez logowania do paneli. Nie zastępuje jednak zgłoszenia mapy w Search Console, gdzie widać, ile adresów Google odczytał i czy mapa ma błędy. Pilnuj też spójności: w mapie nie powinno być adresów, które w tym samym pliku robots.txt blokujesz. Budowę samej mapy opisujemy w osobnym poradniku o mapie strony XML.
Tester robots txt: jak sprawdzić plik w Search Console?
Dawny tester pliku robots txt w Search Console Google wycofał w grudniu 2023 roku. Zastąpił go raport robots.txt w sekcji Ustawienia usługi, a pojedyncze adresy sprawdzasz narzędziem do sprawdzania adresów URL. Oba są darmowe i wymagają zweryfikowanej usługi.
- 1Otwórz raport robots.txt
W Search Console wejdź w Ustawienia, a następnie w raport robots.txt. Raport działa dla usługi domeny albo usługi z prefiksem adresu bez ścieżki.
- 2Przeczytaj stan pobierania
Raport pokazuje pliki dla maksymalnie 20 głównych hostów, z wersją http i https. Stan „Pobrano” jest prawidłowy. Brak pliku z kodem 404 także jest dopuszczalny.
- 3Sprawdź kolumnę Problemy
Kliknij plik, a zobaczysz jego treść z podświetlonymi błędami i ostrzeżeniami. Błąd oznacza, że reguła nie działa. W Wersjach jest historia pliku z ostatnich 30 dni.
- 4Przetestuj konkretny adres
Wklej adres w górnym pasku Search Console. Jeśli jest zablokowany, narzędzie pokaże, że skanowanie nie jest dozwolone przez plik robots.txt.
- 5Poproś o ponowne pobranie
Po poprawce kliknij menu przy pliku i wybierz prośbę o ponowne zindeksowanie. Przydaje się, gdy przez pomyłkę zablokowałeś ważne adresy.
Nazwy elementów podajemy według polskiej wersji Search Console (stan na listopad 2026). Do testów lokalnych Google udostępnia otwartą bibliotekę parsera robots.txt, a crawlery SEO, na przykład Screaming Frog, pozwalają przetestować nowy plik na całej stronie przed publikacją. Konfigurację Search Console opisujemy na stronie Google Search Console.
Boty AI w robots.txt: GPTBot, Google-Extended, ClaudeBot i inne
Dostawcy AI używają osobnych botów do trenowania modeli i do wyszukiwania odpowiedzi. Blokada bota treningowego nie usuwa Cię z wyszukiwarki AI, a blokada bota wyszukującego może ograniczyć cytowania Twojej strony. Dlatego każdą decyzję warto podjąć osobno.
| Bot w robots.txt | Dostawca | Do czego służy według dokumentacji |
|---|---|---|
| GPTBot | OpenAI | pobieranie treści, które mogą trafić do trenowania modeli |
| OAI-SearchBot | OpenAI | pokazywanie stron w wynikach wyszukiwania ChatGPT |
| ChatGPT-User | OpenAI | wizyty na prośbę użytkownika, robots.txt może nie być stosowany |
| Google-Extended | zgoda na użycie treści w Gemini, bez wpływu na wyniki Google | |
| ClaudeBot | Anthropic | zbieranie treści, które mogą trafić do trenowania modeli |
| Claude-SearchBot | Anthropic | indeksowanie na potrzeby wyszukiwania w Claude |
| Claude-User | Anthropic | pobieranie stron, gdy pyta o nie użytkownik |
| PerplexityBot | Perplexity | pokazywanie i linkowanie stron w wynikach Perplexity |
| Perplexity-User | Perplexity | wizyty na prośbę użytkownika, zwykle ignoruje robots.txt |
Przykład pliku, który nie pozwala używać treści do trenowania modeli, ale zostawia otwarte boty wyszukujące, wygląda tak:
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: *
Disallow: /koszyk
Google-Extended nie jest osobnym robotem, tylko znacznikiem w pliku: strony nadal pobiera zwykły Googlebot, a znacznik decyduje, czy treść może posłużyć Gemini. Google zaznacza w dokumentacji, że Google-Extended nie wpływa na obecność w wyszukiwarce ani na pozycje. Nie daje też możliwości wyłączenia strony z AI Overviews, bo te korzystają z indeksu wyszukiwarki.
Jeśli zależy Ci na tym, żeby ChatGPT, Claude czy Perplexity cytowały Twoją stronę, nie blokuj OAI-SearchBot, Claude-SearchBot i PerplexityBot. O tym, jak sprawdzić, czy roboty AI widzą stronę, i jak budować widoczność w odpowiedziach AI, piszemy na stronach pozycjonowanie w AI i llms.txt.
Nazwy i opisy botów według dokumentacji OpenAI, Google Search Central, pomocy Anthropic i dokumentacji Perplexity, stan na listopad 2026. Dostawcy dodają nowe boty, więc listę warto sprawdzać co kilka miesięcy.
Najczęstsze błędy w pliku robots.txt i jak je naprawić
Większość problemów z robots.txt nie wynika ze złej woli, tylko z kopiowania gotowców, pozostałości po wdrożeniu i aktualizacji CMS. Poniżej przypadki, które spotykamy w audytach najczęściej.
| Błąd | Skutek | Jak naprawić |
|---|---|---|
| Disallow: / po przeniesieniu strony z serwera testowego | Google przestaje pobierać całą stronę | usuń regułę i poproś o odświeżenie pliku |
| blokada katalogów z CSS i JavaScript | Google widzi stronę bez wyglądu i części treści | otwórz katalogi motywu i skryptów |
| noindex na stronie zablokowanej w pliku | adres zostaje w indeksie bez opisu | zdejmij blokadę, aż Google zobaczy noindex |
| reguła z błędną wielkością liter | blokada nie działa | przepisz ścieżkę dokładnie jak w adresach |
| zbyt szeroki wzorzec z gwiazdką | blokuje też kategorie i produkty | przetestuj regułę na liście ważnych adresów |
| plik zwraca błąd 5xx lub przekierowuje w pętli | Google wstrzymuje skanowanie strony | napraw serwer, plik musi zwracać kod 200 |
| grupa dla Googlebota bez reguł z grupy * | Googlebot pobiera to, co miało być zamknięte | powtórz wspólne reguły w grupie Googlebota |
Jedna rada na koniec: trzymaj kopię każdej wersji pliku z datą zmiany. Gdy w raporcie indeksowania coś nagle spada, porównanie wersji pozwala znaleźć przyczynę w kilka minut.
Czy robots.txt wpływa na pozycje w Google?
Sam plik robots.txt nie podnosi pozycji. Seo robot txt działa pośrednio: pozwala Google szybciej docierać do stron, które mają znaczenie, i nie rozpraszać się na tysiącach adresów bez wartości. Na małej stronie firmowej z kilkudziesięcioma podstronami różnicy zwykle nie zobaczysz. W sklepie z filtrami i dziesiątkami tysięcy kombinacji adresów różnica bywa wyraźna w tym, jak szybko nowe produkty pojawiają się w wynikach.
Plik może za to bardzo zaszkodzić, gdy blokuje coś, czego nie powinien. Robot txt google traktuje dosłownie: jedna linia potrafi wyłączyć z wyników cały katalog produktów. Dlatego zmiany w pliku wprowadzamy tak samo ostrożnie jak przekierowania przy migracji, z listą adresów do przetestowania przed i po. Szerzej o kolejności prac technicznych piszemy na stronie optymalizacja SEO.
Ile kosztuje sprawdzenie i poprawa pliku robots.txt?
Raport robots.txt w Search Console i narzędzie do sprawdzania adresów nic nie kosztują. Płacisz, gdy chcesz przeglądu całej techniki strony, wdrożenia poprawek albo stałej kontroli. Wycenę wysyłamy w 24 h.
| Usługa | Cena | Co dostajesz |
|---|---|---|
| Raport robots.txt w Search Console | 0 zł | stan pliku, błędy składni, historia 30 dni |
| Darmowa analiza SEO | 0 zł | podstawowe problemy techniczne, wynik od razu na ekranie |
| Audyt SEO | od 1 229 zł brutto | robots.txt, metatagi robots, blokady botów, plan poprawek |
| Jednorazowa optymalizacja SEO | od 3 690 zł brutto | nowy plik, poprawki noindex i mapy witryny |
| Pozycjonowanie strony | od 1 190 zł brutto / mies. | stała kontrola techniki w ramach SEO |
Ceny brutto (zawierają 23% VAT). Audyt od 1 229 zł brutto (999 zł netto), optymalizacja od 3 690 zł brutto (3 000 zł netto). Przy dużych sklepach wycena jest indywidualna i zależy od liczby podstron. Szybki przegląd podstaw zrobisz w darmowej analizie SEO.
Chcesz mieć pewność, że robots.txt nie blokuje stron, które mają sprzedawać? Wycenę audytu wysyłamy w 24 h.
Wyceń audytKomu najczęściej pomagamy z plikiem robots.txt
Sklepy z filtrami
Chcesz zamknąć filtry i sortowanie, a zostawić otwarte kategorie i produkty.
SEO sklepuStrony po wdrożeniu
Nowa wersja strony wypadła z Google, bo przeszła z serwera testowego z blokadą.
Migracja SEOStrony na WordPressie
Masz kilka wtyczek SEO i nie wiesz, która z nich steruje plikiem.
SEO WordPressMarki w odpowiedziach AI
Chcesz świadomie zdecydować, którym botom AI pozwolić, a którym nie.
SEO w AIStrony po spadkach
Ruch spadł nagle i szukasz przyczyny, także w technice.
Odzyskiwanie pozycjiNowe strony
Budujesz stronę i chcesz mieć poprawny plik od pierwszego dnia.
Tworzenie stronCo robimy, a czego nie robimy przy robots.txt
Robimy
- reguły testowane na liście ważnych adresów
- komentarz przy każdej nietypowej linii
- spójność pliku, metatagów i mapy witryny
- kontrolę raportów po zmianie
Nie robimy
- kopiowania gotowców bez sprawdzenia ścieżek
- ukrywania poufnych danych tylko w robots.txt
- blokowania botów AI bez Twojej decyzji
- obietnic pozycji po samej zmianie pliku
Usługi powiązane z plikiem robots.txt
Robots.txt to jeden z elementów technicznego SEO. Wybierz usługę albo napisz, a doradzimy, od czego zacząć.
Najczęstsze pytania o plik robots.txt
Nie ma tu odpowiedzi na Twoje pytanie? Napisz albo zadzwoń, odpowiemy w ciągu 1 dnia roboczego.
Zadaj pytanieCo to jest plik robots.txt?
Robots.txt to zwykły plik tekstowy w głównym katalogu domeny, na przykład twojafirma.pl/robots.txt. Zawiera reguły, które mówią robotom wyszukiwarek i botom AI, których adresów nie powinny pobierać. Plik działa na zasadzie prośby: Googlebot i inne uczciwe roboty go respektują, ale nie jest zabezpieczeniem przed dostępem.
Czy robots.txt usuwa stronę z Google?
Nie. Disallow w robots.txt blokuje pobieranie strony, ale adres może zostać w indeksie, jeśli prowadzą do niego linki, tylko bez opisu. Żeby strona zniknęła z wyników, musi być dostępna dla Googlebota i mieć metatag noindex, albo zwracać kod 404 lub 410.
Czy można wpisać noindex w robots.txt?
Nie. Google przestał obsługiwać dyrektywę noindex w pliku robots.txt we wrześniu 2019 roku i ją ignoruje. Noindex ustawia się w metatagu robots w kodzie strony albo w nagłówku HTTP X-Robots-Tag.
Gdzie znaleźć tester robots.txt?
Dawny tester robots.txt w Search Console Google wycofał pod koniec 2023 roku. Zastąpił go raport robots.txt w Ustawieniach usługi, który pokazuje pobrane pliki, błędy i historię z 30 dni. Czy konkretny adres jest zablokowany, sprawdzisz narzędziem do sprawdzania adresów URL.
Jak dodać mapę strony do robots.txt?
Dopisz w dowolnym miejscu pliku linię Sitemap z pełnym adresem mapy, na przykład Sitemap: https://twojafirma.pl/sitemap.xml. Linia nie należy do żadnej grupy User-agent, a map możesz wskazać kilka. Mapę i tak warto zgłosić w Search Console, bo tam zobaczysz jej stan.
Jak zablokować GPTBot i inne boty AI?
Dodaj osobną grupę dla każdego bota, na przykład User-agent: GPTBot i pod spodem Disallow: /. Pamiętaj, że blokada GPTBot dotyczy trenowania modeli, a za widoczność w wyszukiwarce ChatGPT odpowiada OAI-SearchBot. Podobnie Google-Extended wyłącza użycie treści w Gemini, ale nie wpływa na wyniki Google.
Co oznacza gwiazdka w robots.txt?
W linii User-agent: * gwiazdka oznacza wszystkie roboty, które nie mają w pliku własnej grupy. W ścieżkach Disallow i Allow gwiazdka zastępuje dowolny ciąg znaków, a znak $ oznacza koniec adresu. Reguła Disallow: /*.pdf$ zablokuje więc wszystkie adresy kończące się na .pdf.
Jak edytować robots.txt w WordPress?
WordPress tworzy wirtualny plik robots.txt, którego nie ma na serwerze. Najprościej edytować go we wtyczce SEO, na przykład w Yoast SEO w narzędziach i edytorze plików albo w Rank Math. Możesz też wgrać własny plik robots.txt przez FTP do katalogu głównego, wtedy ma on pierwszeństwo przed wirtualnym.
Ile kosztuje sprawdzenie robots.txt?
Raport robots.txt w Search Console jest darmowy. W Backlink24 robots.txt, metatagi robots i blokady botów sprawdzamy w audycie SEO od 1 229 zł brutto, a poprawki wdrażamy w jednorazowej optymalizacji od 3 690 zł brutto albo w stałym pozycjonowaniu. Wycenę wysyłamy w 24 h.
Sprawdźmy plik robots.txt Twojej strony
Podaj adres strony i napisz, na jakiej platformie działa oraz co widzisz w Search Console. Odpowiemy z listą problemów i wyceną w 24 h. Możesz też zadzwonić albo napisać na WhatsApp.
Napisz do nas
Odpowiadamy zwykle w ciągu jednego dnia roboczego.
Zapisz się do nowej platformy Backlink24 i odbierz 10% rabatu
Wkrótce uruchamiamy panel, w którym sam sprawdzisz swoje strony, zamówisz nowe pakiety linków i opublikujesz artykuły na portalach. Zapisani dostaną dostęp jako pierwsi i kod rabatowy na pierwsze zamówienie.
- weryfikacja stron
- zamawianie pakietów
- publikacja artykułów
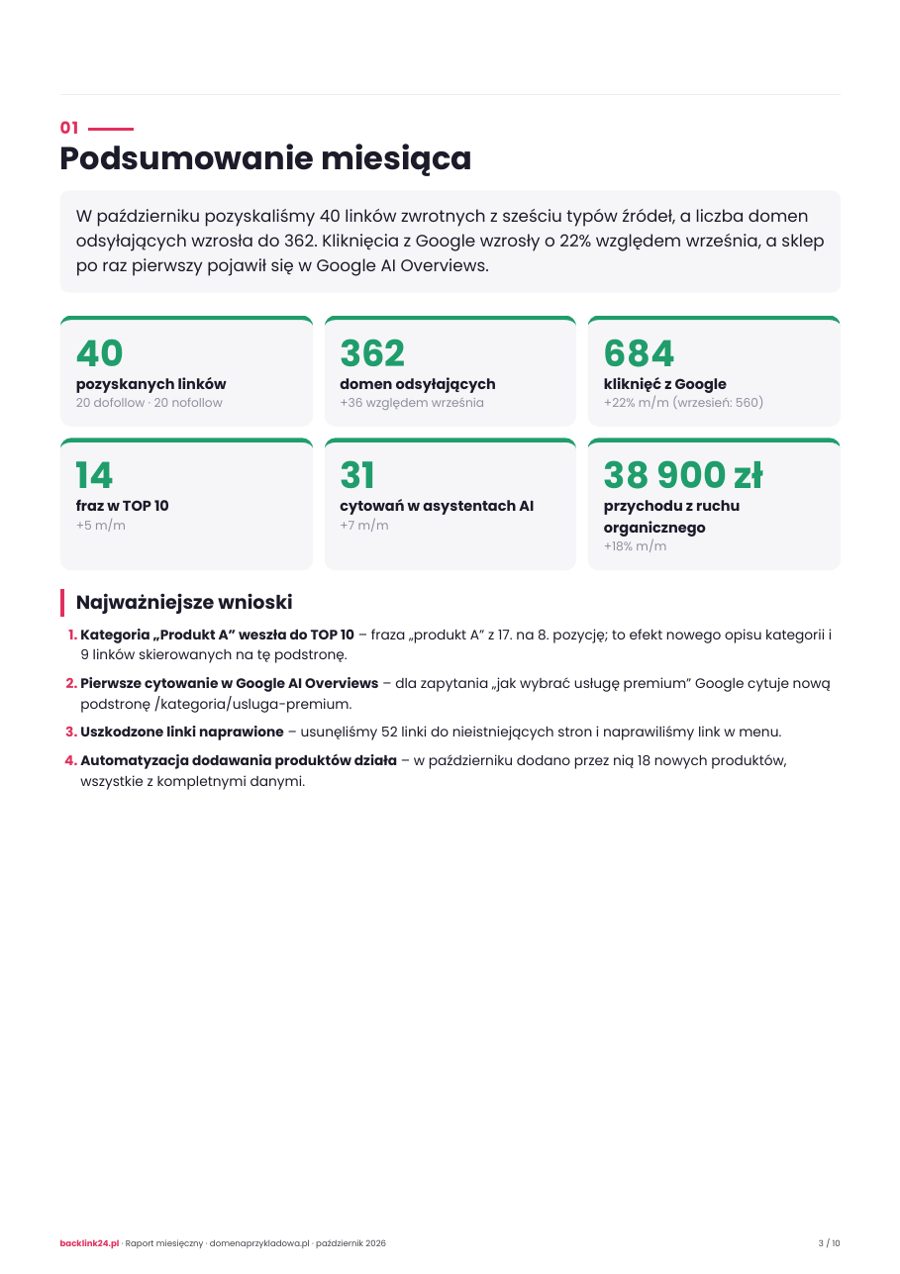
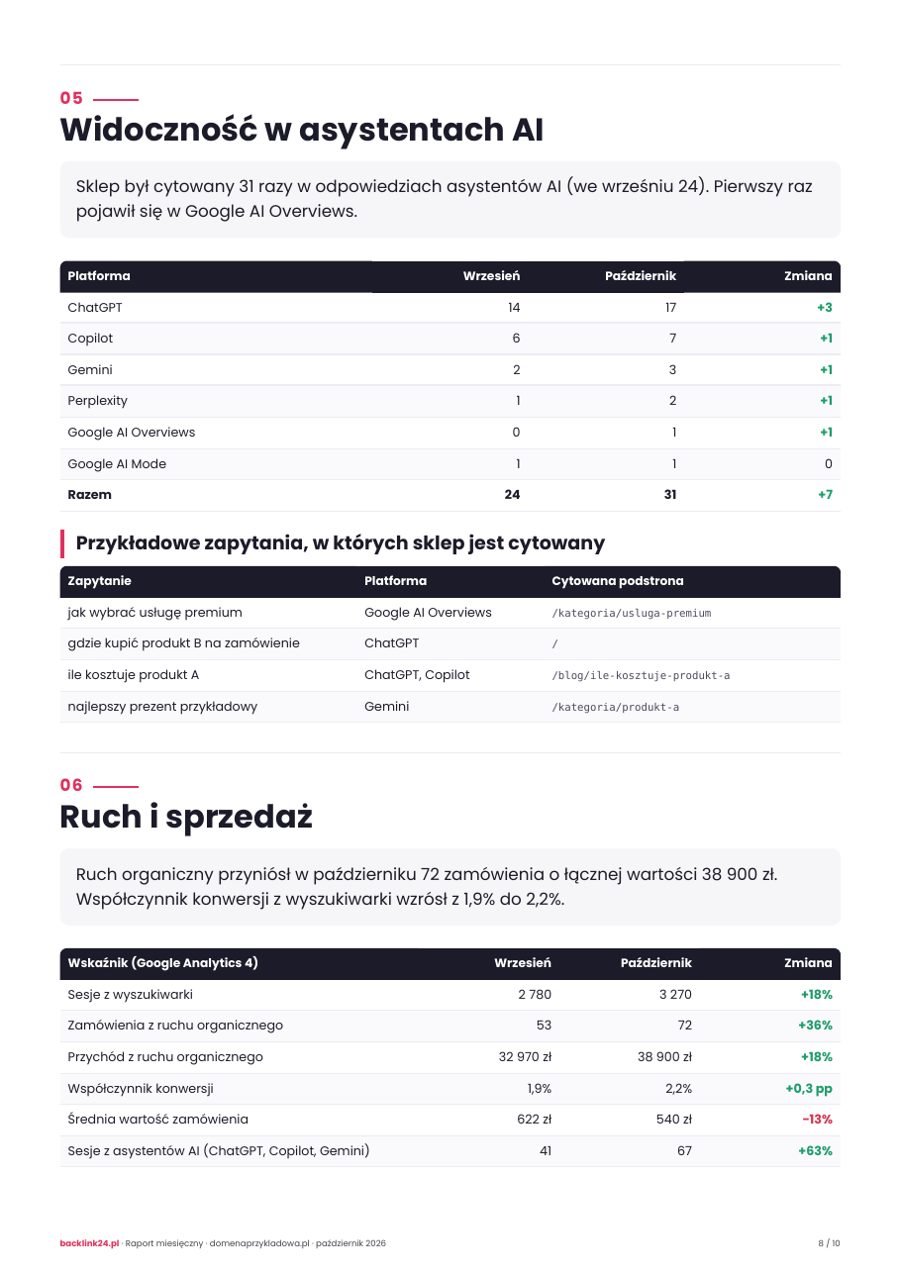
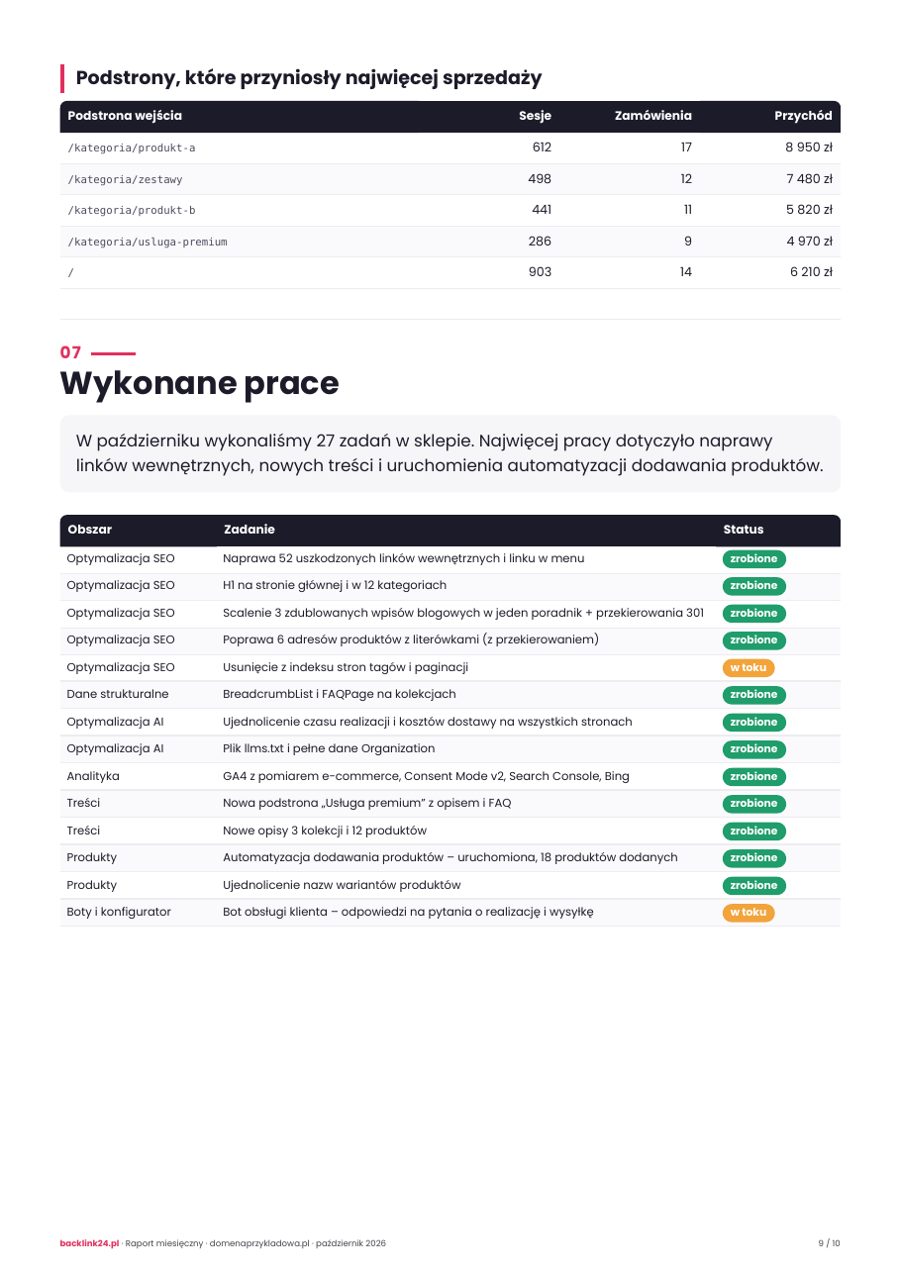
Tak wygląda raport, który dostajesz co miesiąc
Przykład na danych przykładowych: lista pozyskanych linków z adresami, widoczność w Google i w asystentach AI, ruch i sprzedaż z Google Analytics 4, wykonane prace i plan na kolejny miesiąc. Pełny raport ma 10 stron.