Googlebot: jak Google indeksuje strony, crawl budget i mobile first
Od odkrycia adresu do wyniku w Google: skanowanie, renderowanie, indeksowanie, budżet indeksowania i wersja mobilna
- według dokumentacji Google
- user agent i weryfikacja
- wycena audytu w 24 h
Googlebot to robot, którym Google pobiera strony internetowe. Google indeksuje strony w trzech krokach: Googlebot znajduje adres i pobiera stronę, system renderuje ją jak przeglądarka, a potem Google analizuje treść i decyduje, czy zapisać ją w indeksie. Od tego, jak sprawnie przebiegają te kroki, zależy, czy i kiedy podstrona pojawi się w wynikach. Skanowanie i indeksowanie strony analizujemy w audycie SEO Backlink24 od 1 229 zł brutto.
16 latdoświadczenia w SEO
400+obsłużonych stron i serwisów
Spis treści22 sekcje
- W skrócie
- Usługi i ceny
- Case study i opinie
- Co analizujemy
- Jak pracujemy
- Googlebot: co to jest
- Jak Google indeksuje strony
- Rodzaje robotów Google
- User agent i weryfikacja
- Renderowanie JavaScript
- Co Googlebot pobiera
- Crawl budget
- Statystyki indeksowania
- Mobile first index
- Optymalizacja pod urządzenia mobilne
- Ile trwa indeksowanie
- Mity o Googlebocie
- Ile to kosztuje
- Powiązane usługi
- FAQ
- Kontakt
- Autor strony

Sprawdzimy, jak Google skanuje Twoją stronę
Podaj adres strony. Odpowiadamy w ciągu jednego dnia roboczego, z listą problemów i ceną poprawek. Bez zobowiązań.
Zostaw adres strony, a sprawdzimy, czy Googlebot dociera do ważnych podstron
Odpowiadamy w ciągu jednego dnia roboczego, z listą problemów i ceną poprawek. Bez zobowiązań.
W skrócie
- Googlebot to robot wyszukiwarki Google w dwóch odmianach: na smartfony i na komputery. Większość wizyt pochodzi od robota mobilnego, bo Google indeksuje strony w wersji mobilnej.
- Droga do wyników ma etapy: odkrycie adresu, pobranie, renderowanie, analiza i wybór wersji kanonicznej, zapis w indeksie. Na każdym etapie strona może odpaść.
- Crawl budget ma znaczenie głównie dla dużych serwisów. Małej stronie firmowej bardziej szkodzą duplikaty, blokady i słaba treść niż budżet indeksowania.
- Googlebot pobiera pierwsze 2 MB pliku HTML. Prawdziwego robota rozpoznasz po odwrotnym DNS, a nie po nazwie w nagłówku user agent.
16 latdoświadczenia w SEO
Logi i GSCdane zamiast domysłów
Raportz listą zmian do wdrożenia
Krakówbiuro, obsługa w całej Polsce
Gdy Googlebot omija Twoją stronę: usługi i ceny
Ten poradnik wyjaśnia, jak działa robot Google. Jeśli po lekturze widzisz, że część podstron nie trafia do wyników, a raporty w Search Console są pełne wykluczonych adresów, sprawdzimy przyczynę w audycie i wdrożymy poprawki.
Audyt SEO
gdy chcesz wiedzieć, gdzie strona odpada
od 1 229 złbrutto · zależnie od wielkości strony
- skanowanie strony jak Googlebot
- renderowanie i wersja mobilna
- statystyki indeksowania i stan hosta
Jednorazowa optymalizacja
poprawki techniki i struktury
od 3 690 złbrutto · jednorazowo
- porządek w duplikatach i parametrach
- linkowanie do ważnych podstron
- poprawki wersji mobilnej
Pozycjonowanie strony
indeksowanie pod stałą kontrolą
od 1 190 złbrutto / mies. · pakiety SEO
- kontrola raportów indeksowania co miesiąc
- treści i linki z portali
- raport z wykonanymi pracami
Ceny aktualne na 11 listopada 2026. Ceny brutto (zawierają 23% VAT). Audyt od 1 229 zł brutto (999 zł netto), optymalizacja od 3 690 zł brutto (3 000 zł netto). Pozycjonowanie: pakiety 1 190, 1 790, 2 490 i 2 990 zł brutto miesięcznie, czas nieokreślony, 1 miesiąc wypowiedzenia.
Nowe podstrony tygodniami czekają na Google? Napisz, co widzisz
Podaj adres strony i kilka przykładowych adresów, które nie wchodzą do indeksu. Sprawdzimy, na którym etapie odpadają: odkrycia, pobrania, renderowania czy oceny treści.
Najpierw ustalamy, na którym etapie strona odpada
„Google nie indeksuje strony” to objaw, a nie diagnoza. Adres może być nieznany robotowi, pobrany, ale źle wyrenderowany, albo przeanalizowany i odrzucony jako duplikat. Każdy z tych przypadków leczy się inaczej, więc zaczynamy od ustalenia etapu.
- Odkrycie
Czy do adresu prowadzą linki wewnętrzne i czy jest w mapie witryny.
- Pobranie
Czy serwer odpowiada szybko i poprawnie, a robots.txt nie blokuje adresu ani zasobów.
- Renderowanie
Czy po wykonaniu skryptów treść i linki są widoczne dla robota.
- Ocena
Czy strona nie jest duplikatem, ma własną wartość i właściwy adres kanoniczny.
Case study: od zera do 100 000 wejść miesięcznie
Case study w liczbach. MamyRecepte.pl: 90 tys. wejść miesięcznie i 346 fraz w TOP 1-3. Randkujmy: 100 tys. wejść i 1 300 fraz w TOP 1-3. Eurofance.pl: +10 tys. wejść i 400 fraz w TOP 1-3.

MamyRecepte.pl: od zera do 90 000 wejść miesięcznie
Serwis z receptami online w branży, w której Google ocenia treści najsurowiej. Dziś jest na pierwszej stronie obok NFZ i dużych platform medycznych, a ChatGPT, Perplexity i Google AI cytują go jako źródło.


Randkujmy: od zera do 100 000 wejść miesięcznie
Domena bez historii, bez linków i bez ruchu w jednej z najbardziej konkurencyjnych nisz w Polsce. Dziś jest w czołówce na „portal randkowy” i na setki fraz lokalnych „randki + miasto”.


Eurofance.pl: +10 000 wejść miesięcznie po spadku
Projekt startował ze spadkami po aktualizacji algorytmu Google, strona straciła widoczność. Przemodelowaliśmy strategię od podstaw: optymalizacja techniczna i treści, linki z mocnych portali i stała praca nad podstronami przywróciły ruch organiczny i wyraźnie go zwiększyły.
Więcej case study: sklep z sukienkami (9 500 fraz w TOP 1-3), sklep z winem, sklep medyczny i inne
Co mówią nasi klienci
BackLink24 wyróżnia się spośród wszystkich firm, z którymi współpracowaliśmy do tej pory. Bardzo ważna jest dla nas terminowość i rzetelność wykonywanych działań. Kładziemy ogromny nacisk na jakość tego, co robimy i dlatego też chcemy współpracować tylko z najlepszymi partnerami. BackLink24 spełnia nasze oczekiwania w tym zakresie. Współpraca rozpoczęła się od propozycji ciekawych i co najważniejsze skutecznych strategii a dzisiaj możemy śmiało stwierdzić, że efekty tych działań przerosły nasze oczekiwania.
Jesteśmy zadowoleni zarówno z jakości pozyskiwanych linków, jak i z komunikacji z firmą. Zespół BackLink24 jest w stanie podołać każdemu zadaniu. Nawet takiemu, które na pierwszy rzut oka wydaje się niemożliwe. To dla nas bardzo ważne, bo wysokie pozycje zapewniają nam wzrost liczby klientów. Co tu dużo mówić, jeżeli dobrze to tylko w BackLink24 :).
Serdecznie polecam usługi BackLink24. Na plus zarówno kontakt, jak i podejście do klienta. Mogę dzwonić w każdej chwili i zawsze mam gwarancję, że zajmą się moją sprawą. W branży SEO takie detale są naprawdę bardzo ważne. Często jest tak, że potrzebuje czegoś „na już”, a w tym przypadku zawsze mogę liczyć na wsparcie.
Od dłuższego czasu regularnie współpracujemy z Backlink24.pl, doceniając ich przemyślane podejście do budowania profilu linkowego. Wysoka jakość publikacji, przejrzystość działań oraz zauważalne efekty w postaci poprawy widoczności strony sprawiają, że jest to partner, któremu warto zaufać. Profesjonalizm zespołu i dobra komunikacja czynią Backlink24.pl ważnym elementem naszych działań SEO.


MamyRecepte.pl: od zera do 90 000 wejść miesięcznie
Serwis z receptami online w branży, w której Google ocenia treści najsurowiej, a konkurencją są duże podmioty medyczne z wieloletnim autorytetem. Dziś MamyRecepte.pl ma 90 000 wejść miesięcznie wyłącznie z wyników organicznych i jest cytowany przez modele AI.
Najważniejsze frazy
| Fraza | Pozycja w Google |
|---|---|
| recepta online | TOP 4-5 |
| recepta | TOP 5 |
| antybiotyk na anginę | TOP 5 |
| e-recepta | TOP 6 |
| antybiotyk 3 dniowy | TOP 6 |
| recepty online | TOP 6 |
Frazy w pozycjach 1-3
Frazy w pozycjach 4-10

Cytowania w modelach AI
Co zrobiliśmy
- Strategia pod branżę medycznąanaliza konkurencji i rynku, nacisk na E-E-A-T i zaufanie domeny
- Optymalizacja techniczna i treścistruktura serwisu, szybkość, dane strukturalne, jakość tekstów
- Treści na poziomie eksperckimmerytoryczne odpowiedzi na realne pytania pacjentów
- Linki z wiarygodnych źródełtematycznie powiązane publikacje, ważne w branży zdrowotnej
Randkujmy: od zera do 100 000 wejść miesięcznie
Portal randkowy startował bez historii domeny, bez linków i bez ruchu, w niszy zdominowanej przez marki z wieloletnią przewagą. Dziś zajmuje czołowe pozycje na „portal randkowy” i „portale randkowe” oraz na setki fraz lokalnych w całym kraju.
Najważniejsze frazy
| Fraza | Pozycja w Google |
|---|---|
| portal randkowy | TOP 1-2 |
| portale randkowe | TOP 2 |
| randki | TOP 5 |
| ogłoszenia towarzyskie | TOP 10 |
Do tego setki fraz lokalnych, m.in. randki Warszawa, randki Kraków, randki Wrocław, portal randkowy Poznań.
Frazy w pozycjach 1-3
Frazy w pozycjach 4-10
Co zrobiliśmy
- Pełna optymalizacja platformyszybkość, adresy URL, dane strukturalne, indeksacja, Core Web Vitals
- Ciągła rozbudowa treścifrazy ogólne, długi ogon i setki fraz lokalnych
- Poprawa UX i zaangażowaniamniej odrzuceń, dłuższe sesje, chętniejsze powroty
- Pozyskiwanie linkówprowadzone równolegle i bez przerwy przez cały czas współpracy
Co analizujemy, gdy sprawdzamy pracę Googlebota na stronie?
Do analizy łączymy trzy źródła: raporty Search Console, własny skan strony crawlerem ustawionym jak Googlebot Smartphone oraz, gdy hosting na to pozwala, logi serwera z prawdziwymi wizytami robota.
- Statystyki indeksowania
Liczba żądań, czas odpowiedzi, kody odpowiedzi i stan hosta z ostatnich 90 dni.
- Logi serwera
Które sekcje robot odwiedza najczęściej, a których nie widział od miesięcy.
- Renderowanie
Porównanie kodu źródłowego z kodem po wyrenderowaniu w narzędziu do sprawdzania adresów.
- Struktura linków
Głębokość kliknięć do ważnych podstron i strony bez żadnych linków wewnętrznych.
- Zbędne adresy
Filtry, parametry, paginacja i duplikaty, które zjadają czas robota.
- Wersja mobilna
Czy telefon dostaje tę samą treść, dane strukturalne i metatagi co komputer.
Jak pracujemy nad indeksowaniem strony krok po kroku
Najpierw zbieramy dane o tym, co robot naprawdę robi na stronie, potem usuwamy przeszkody, a na końcu sprawdzamy, czy zmiany przełożyły się na liczbę zindeksowanych adresów.
Dane
Search Console, skan strony i logi serwera pokazują, gdzie robot bywa, a gdzie nie dociera.
na startPoprawki
Porządkujemy duplikaty, linkowanie, blokady i renderowanie, zaczynając od podstron, które mają zarabiać.
wdrożenieKontrola
Śledzimy raport indeksowania stron i statystyki indeksowania przez kolejne tygodnie.
po wdrożeniu
Googlebot: co to jest robot Google?
Googlebot to ogólna nazwa robota, którym wyszukiwarka Google pobiera strony internetowe. Robot przechodzi po linkach, odczytuje mapy witryn, pobiera kod stron i przekazuje go dalej do systemów, które renderują strony i budują indeks. Sam Googlebot nie decyduje o pozycjach: jego zadaniem jest dostarczenie treści, a ocena odbywa się później.
Googlebot działa na tysiącach maszyn jednocześnie, ale według dokumentacji Google Search Central na większości stron pojawia się średnio nie częściej niż raz na kilka sekund. Gdy serwer zaczyna odpowiadać wolno albo zwraca błędy 5xx lub 429, robot sam zwalnia, żeby nie przeciążyć strony. Jeśli wizyty robota naprawdę obciążają serwer, Google opisuje w pomocy sposób na czasowe ograniczenie skanowania.
Robot Google to nie jedyny robot w logach. Obok niego pracują Bingbot, roboty narzędzi SEO i coraz więcej botów AI. O tym, jak sterować nimi plikiem robots.txt, piszemy w osobnym poradniku. Tu skupiamy się na tym, co dzieje się ze stroną po wizycie Googlebota. Pełną usługę naprawy indeksacji opisujemy na stronie indeksowanie strony w Google.
Jak Google indeksuje strony: od odkrycia adresu do wyniku
Google indeksuje strony w kilku etapach: odkrywa adres, pobiera stronę robotem, renderuje ją, analizuje treść i wybiera wersję kanoniczną, a dopiero potem zapisuje w indeksie. Wyświetlanie w wynikach to osobny krok, w którym liczy się już dopasowanie do zapytania i jakość.
- 1Odkrywanie adresu
Google dowiaduje się o adresie z linków na innych stronach, z linków wewnętrznych, z mapy witryny albo ze zgłoszenia w Search Console. Strona, do której nic nie prowadzi, może pozostać nieznana.
- 2Skanowanie
Googlebot pobiera kod strony. Wcześniej sprawdza robots.txt, a potem ocenia odpowiedź serwera. Błąd, przekierowanie albo zbyt wolna odpowiedź mogą zatrzymać adres na tym etapie.
- 3Renderowanie
Pobrana strona trafia do usługi renderującej opartej na aktualnym Chromium, która wykonuje JavaScript i pobiera pliki CSS. Dopiero wtedy Google widzi stronę mniej więcej tak jak użytkownik.
- 4Analiza i kanonikalizacja
Google czyta treść, nagłówki, metatagi, dane strukturalne i linki. Spośród podobnych stron wybiera jedną wersję kanoniczną, a pozostałe traktuje jako duplikaty.
- 5Indeksowanie
Wybrana wersja może trafić do indeksu, czyli bazy, z której Google buduje wyniki. Nie każda pobrana strona jest indeksowana: Google pomija m.in. strony z noindex i treści o niskiej wartości.
- 6Wyświetlanie w wynikach
Przy każdym zapytaniu Google wybiera z indeksu strony najlepiej pasujące do pytania i miejsca użytkownika. Zaindeksowana strona nie musi się wyświetlać wysoko ani często.
Etapy opisujemy według przewodnika Google Search Central o działaniu wyszukiwarki (stan na listopad 2026). Wiele osób myli skanowanie z indeksowaniem: crawl googlebot oznacza tylko pobranie strony, a indeks to dopiero zapis wybranej wersji w bazie Google.
Rodzaje robotów Google: Googlebot Mobile, Desktop i inne
Googlebot ma dwie odmiany: Googlebot Smartphone i Googlebot Desktop. Obie używają tej samej nazwy w robots.txt, więc nie da się zablokować tylko jednej z nich. Obok nich Google ma roboty dla obrazów, wideo, wiadomości, zakupów i narzędzi testowych.
| Robot | Nazwa w robots.txt | Do czego służy |
|---|---|---|
| Googlebot Smartphone | Googlebot | główny robot wyszukiwarki, udaje użytkownika telefonu |
| Googlebot Desktop | Googlebot | udaje komputer, odpowiada za mniejszość wizyt |
| Googlebot-Image | Googlebot-Image | Grafika Google, Discover, obrazy w wynikach |
| Googlebot-Video | Googlebot-Video | funkcje wideo w wyszukiwarce |
| Googlebot-News | Googlebot-News | Google News, bez własnego user agent |
| Storebot-Google | Storebot-Google | powierzchnie zakupowe Google |
| Google-InspectionTool | Google-InspectionTool | narzędzia testowe, np. sprawdzanie adresu URL |
| GoogleOther | GoogleOther | ogólny robot różnych zespołów Google |
| Google-Extended | Google-Extended | tylko znacznik zgody na użycie treści w Gemini, nie osobny robot |
Lista według dokumentacji Google o popularnych robotach (stan na listopad 2026). Google-Extended nie wpływa na obecność strony w wyszukiwarce ani na pozycje.
User agent Googlebot: jak rozpoznać prawdziwego robota Google?
Każde żądanie robota ma nagłówek user agent z jego nazwą. Googlebot przedstawia się ciągiem z fragmentem Googlebot/2.1 i adresem strony z opisem robota. W miejscu W.X.Y.Z jest aktualna wersja Chrome, która zmienia się razem z przeglądarką:
Googlebot Smartphone:
Mozilla/5.0 (Linux; Android 6.0.1; Nexus 5X Build/MMB29P) AppleWebKit/537.36
(KHTML, like Gecko) Chrome/W.X.Y.Z Mobile Safari/537.36
(compatible; Googlebot/2.1; +http://www.google.com/bot.html)

Googlebot Desktop:
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko; compatible; Googlebot/2.1;
+http://www.google.com/bot.html) Chrome/W.X.Y.Z Safari/537.36
Googlebot 2.1 w nagłówku nie oznacza żadnej starej wersji robota, to po prostu stały fragment identyfikatora. Ważniejsze jest to, że nagłówek łatwo podrobić. Część skanerów, scraperów i botów spamowych podaje się za Googlebota, żeby ominąć blokady. Dlatego przy analizie logów albo przed zablokowaniem podejrzanego ruchu warto sprawdzić, czy wizyta naprawdę pochodzi od Google.
Jak zweryfikować Googlebota w dwóch krokach
Pierwszy sposób to odwrotne zapytanie DNS dla adresu IP z logów. Prawdziwy robot ma nazwę hosta w domenie googlebot.com, na przykład w postaci crawl-...googlebot.com. Następnie robisz zwykłe zapytanie DNS dla tej nazwy i sprawdzasz, czy wraca ten sam adres IP. Drugi sposób to porównanie IP z zakresami adresów, które Google publikuje w plikach JSON w dokumentacji Search Central.
host 66.249.66.1
1.66.249.66.in-addr.arpa domain name pointer crawl-66-249-66-1.googlebot.com.

host crawl-66-249-66-1.googlebot.com
crawl-66-249-66-1.googlebot.com has address 66.249.66.1
Jeśli obie odpowiedzi się zgadzają, wizyta pochodzi od Google. Jeśli nazwa hosta należy do innej domeny, to tylko ktoś, kto podpisuje się jako Googlebot, i taki ruch możesz bez obaw ograniczyć na serwerze.
Renderowanie: czy Googlebot widzi treść ładowaną przez JavaScript?
Tak, Googlebot renderuje strony w aktualnej wersji Chromium i wykonuje JavaScript, ale robi to w kolejce, osobno od pobrania kodu. Większość stron jest renderowana szybko, jednak przy błędach skryptów, zablokowanych zasobach albo treści pokazywanej dopiero po kliknięciu część tekstu i linków może do Google nie dotrzeć.
Najbezpieczniej, gdy najważniejsza treść, nagłówki, linki do kategorii i produktów oraz metatagi są w HTML wysłanym przez serwer. Tak działa renderowanie po stronie serwera albo generowanie statycznych stron. Gdy cała treść powstaje dopiero w przeglądarce, ryzyko rośnie, zwłaszcza w sklepach i aplikacjach webowych.
Jak to sprawdzić: w Search Console wklej adres w pasku sprawdzania, wybierz test opublikowanego adresu URL i otwórz podgląd wyrenderowanego kodu HTML. Jeśli opisu produktu albo linków nie ma w tym widoku, Google ich nie widzi. W tym samym miejscu zobaczysz, czy któreś zasoby nie zostały pobrane. Więcej o technicznej stronie renderowania piszemy na stronie techniczne SEO.
- treść i linki w HTML z serwera, a nie tylko po wykonaniu skryptu
- linki jako zwykłe znaczniki a z atrybutem href
- pliki CSS i JavaScript niezablokowane w robots.txt
- treść w zakładkach i akordeonach obecna w kodzie od początku
Ile treści pobiera Googlebot z jednej strony?
Według dokumentacji Google Search Central zaktualizowanej w lutym 2026 roku Googlebot pobiera pierwsze 2 MB pliku HTML lub innego obsługiwanego formatu tekstowego oraz pierwsze 64 MB pliku PDF. Limit dotyczy danych po rozpakowaniu. Pliki CSS i JavaScript, do których odwołuje się strona, robot pobiera osobno, każdy z tym samym limitem.
Treść za granicą limitu nie jest brana pod uwagę przy indeksowaniu. Dla zwykłej strony firmowej 2 MB samego HTML to bardzo dużo, ale zdarzają się strony, które go przekraczają: kategorie sklepów z setkami produktów wypisanych w kodzie, strony z wklejonymi w HTML obrazami w base64 albo kod rozdmuchany przez kreatory stron. Jeśli opis kategorii jest na samym dole takiego kodu, robot może go nie zobaczyć.
Rozmiar dokumentu sprawdzisz w narzędziach deweloperskich przeglądarki, na karcie sieci, albo w crawlerze SEO. Gdy HTML jest duży, warto przenieść obrazy do osobnych plików, ograniczyć liczbę produktów na jednej stronie kategorii i usunąć zbędny kod z szablonu. Wpływa to także na szybkość strony, o której piszemy na stronie przyspieszenie strony.
Crawl budget: co to jest i kiedy ma znaczenie?
Crawl budget, po polsku budżet indeksowania, to zbiór adresów, które Google może i chce pobrać z danej strony. Wyznaczają go dwie rzeczy: limit wydajności, czyli ile połączeń serwer wytrzyma bez spowolnienia, oraz zapotrzebowanie, czyli jak bardzo Google chce skanować stronę ze względu na jej wielkość, popularność i częstotliwość zmian.
| Typ strony | Czy crawl budget to problem | Na czym się skupić |
|---|---|---|
| strona firmowa, kilkadziesiąt podstron | nie | treść, linkowanie, poprawna mapa witryny |
| blog lub sklep do kilku tysięcy adresów | zwykle nie | duplikaty, filtry, raport indeksowania stron |
| serwis od 10 tys. podstron zmienianych codziennie | może być | parametry, szybkość serwera, logi |
| serwis od 1 mln podstron zmienianych co tydzień | tak | pełne zarządzanie adresami i wydajnością |
| dużo adresów w stanie „wykryta, ale niezindeksowana” | możliwe | sprawdzić wydajność i jakość jednocześnie |
Crawl budget co to oznacza w praktyce?
Progi z tabeli pochodzą z przewodnika Google o zarządzaniu budżetem indeksowania i Google zaznacza, że są orientacyjne. Jeśli publikujesz podstronę, a robot pobiera ją tego samego dnia, budżet nie jest Twoim problemem. Wtedy wystarczy aktualna mapa witryny i regularny rzut oka na raport indeksowania stron.
Co pomaga, a co nie
Pomaga ograniczenie zbędnych adresów: łączenie duplikatów, zamknięcie filtrów i sortowania w robots.txt, zwracanie kodu 404 lub 410 dla stron usuniętych na stałe, naprawa miękkich błędów 404 i skracanie łańcuchów przekierowań. Pomaga szybszy serwer i obsługa odpowiedzi 304 dla niezmienionych stron. Nie pomaga dodawanie noindex do tysięcy adresów, bo Google i tak je pobiera, zanim zobaczy metatag. Blokowanie części strony w robots.txt też nie przesuwa budżetu na inne podstrony, chyba że serwis już dobija do limitu wydajności serwera.
Jak sprawdzić, co Googlebot robi na stronie? Statystyki indeksowania
Raport Statystyki indeksowania w Search Console pokazuje, ile żądań Googlebot wysłał do strony w ostatnich 90 dniach, ile danych pobrał, jak szybko odpowiadał serwer i jakie kody odpowiedzi dostawał. Raport znajdziesz w Ustawieniach usługi.
- 1Otwórz Statystyki indeksowania
W Search Console wejdź w Ustawienia i otwórz raport w sekcji indeksowania. Raport działa na poziomie usługi domeny lub głównego prefiksu.
- 2Sprawdź stan hosta
Zielony stan oznacza, że w ostatnim czasie nie było poważnych problemów z pobraniem robots.txt, DNS ani połączeniem z serwerem.
- 3Przejrzyj odpowiedzi
Rosnący udział błędów 5xx, przekierowań albo 404 to sygnał do sprawdzenia serwera i linków wewnętrznych.
- 4Spójrz na średni czas odpowiedzi
Gdy serwer odpowiada coraz wolniej, Googlebot zmniejsza liczbę żądań. Skok czasu odpowiedzi często poprzedza spadek skanowania.
- 5Sprawdź cel i typ robota
Podział na odkrywanie i odświeżanie pokazuje, czy robot szuka nowych adresów, a podział według typu robota potwierdza, że większość wizyt pochodzi od robota na smartfony.
Raport pokazuje dane zbiorcze. Dokładną listę odwiedzonych adresów dają tylko logi serwera, które na większości hostingów można pobrać z panelu. Konfigurację Search Console opisujemy na stronie Google Search Console, a raporty krok po kroku w poradniku Google Search Console.
Statystyki indeksowania pokazują błędy serwera albo spadek żądań? Wyślij adres, sprawdzimy przyczynę.
Poproś o analizęMobile first index: co oznacza dla SEO Twojej strony?
Mobile first index oznacza, że Google ocenia i indeksuje stronę na podstawie jej wersji mobilnej. Robotem głównym jest Googlebot Smartphone, a Googlebot Desktop odpowiada już tylko za niewielką część wizyt. Google zakończył przechodzenie na indeksowanie mobilne w 2024 roku, a strony, które nie działają na telefonach, mogą mieć problem z obecnością w indeksie.
Dla SEO wynika z tego jedna prosta zasada: to, czego nie ma w wersji mobilnej, dla Google praktycznie nie istnieje. Jeśli na telefonie ukrywasz opis kategorii, skracasz treść usług albo usuwasz linki z menu, Google ocenia stronę po tej uboższej wersji. Przy stronach responsywnych, które wysyłają ten sam kod na każde urządzenie, problem zwykle nie występuje. Pojawia się przy osobnych wersjach mobilnych na subdomenie m. oraz przy szablonach, które ładują inną treść w zależności od urządzenia.
Google seo mobile first to także dane strukturalne i metatagi. Według dokumentacji Google obie wersje powinny mieć ten sam tytuł, opis, dane strukturalne i metatag robots. Szczególnie groźny jest noindex dodany tylko w wersji mobilnej, bo wyłącza stronę z indeksu, mimo że na komputerze wszystko wygląda dobrze.
Optymalizacja strony pod urządzenia mobilne: co sprawdzić?
Optymalizacja strony pod urządzenia mobilne w kontekście indeksowania to nie tylko wygląd na małym ekranie. Chodzi o to, żeby robot na smartfony dostał całą treść, wszystkie ważne linki i te same sygnały co wersja na komputer.
| Element | Co sprawdzić | Dlaczego to ważne |
|---|---|---|
| treść | ten sam tekst na telefonie i komputerze | Google indeksuje wersję mobilną |
| nawigacja | linki do kategorii dostępne w menu mobilnym | robot odkrywa strony po linkach |
| treść ładowana leniwie | ładuje się bez przewijania, kliknięcia i wpisywania | Googlebot nie klika ani nie przewija jak użytkownik |
| dane strukturalne | te same typy w obu wersjach | wyniki rozszerzone bazują na wersji mobilnej |
| metatagi | ten sam title, description i robots | noindex tylko na telefonie wyłącza stronę |
| obrazy i wideo | te same pliki z opisami alt | grafika i wideo w wynikach |
| szybkość | Core Web Vitals dla telefonów | doświadczenie strony liczone osobno dla urządzeń |
Szybkość strony na telefonach sprawdzisz w PageSpeed Insights i raporcie Podstawowe wskaźniki internetowe w Search Console. Przyspieszeniem stron zajmujemy się w ramach usługi przyspieszenie strony, a ogólny test zrobisz na stronie test szybkości strony.
Indeksowanie Google: ile trwa i od czego zależy?
Google podaje w pomocy, że skanowanie zgłoszonej strony może trwać od kilku dni do kilku tygodni, i nie gwarantuje ani terminu, ani samego zindeksowania. W praktyce czas zależy od tego, jak często Googlebot odwiedza domenę: na serwisie, który publikuje codziennie i ma wiele linków z innych stron, nowy artykuł bywa w indeksie po kilku godzinach, a na nowej domenie bez linków czeka się znacznie dłużej.
Indeksowanie google ile trwa w konkretnym przypadku, sprawdzisz w narzędziu do sprawdzania adresów URL: zobaczysz datę ostatniego skanowania i stan indeksowania. Prośba o zindeksowanie w tym narzędziu dodaje adres do kolejki, ale nie skraca oceny strony, a liczba takich próśb jest ograniczona.
- linki wewnętrzne z często odwiedzanych podstron, np. strony głównej
- aktualna mapa witryny z prawdziwą datą lastmod
- szybki serwer bez błędów 5xx
- treść, która nie powiela innych stron w serwisie
- linki z innych stron, które prowadzą robota do nowego adresu
Jeśli podstrona długo nie trafia do indeksu, przyczynę, statusy w raporcie indeksowania i sposoby naprawy opisujemy szczegółowo na stronie indeksowanie strony, gdzie zamawiasz też diagnozę.
Mity o Googlebocie i indeksowaniu, które wciąż krążą
Wokół robota Google narosło sporo przekonań z czasów, gdy wyszukiwarka działała inaczej. Poniżej te, które słyszymy najczęściej, z tym, co na ich temat mówi dokumentacja Google.
| Mit | Jak jest naprawdę |
|---|---|
| częste zgłaszanie adresu przyspiesza indeksowanie | wielokrotne prośby o ten sam adres nic nie zmieniają, kolejka i tak decyduje |
| priority w mapie witryny ustawia kolejność skanowania | Google ignoruje znaczniki priority i changefreq |
| Crawl-delay w robots.txt spowalnia Googlebota | Googlebot nie obsługuje crawl-delay |
| każda strona musi walczyć o crawl budget | dotyczy to głównie dużych serwisów, np. od ok. 10 tysięcy adresów zmienianych codziennie |
| Googlebot nie czyta JavaScriptu | czyta, ale w kolejce i nie zawsze bezbłędnie |
| zaindeksowana strona będzie wysoko | indeks to warunek obecności, nie pozycji |
| płatne narzędzia gwarantują indeksację | nikt poza Google nie decyduje o indeksie, a oficjalna droga to Search Console |
Ile kosztuje analiza skanowania i indeksowania strony?
Raporty Search Console i PageSpeed Insights są darmowe. Płacisz, gdy chcesz pełnej diagnozy, wdrożenia poprawek albo stałej kontroli. Wycenę wysyłamy w 24 h.
| Usługa | Cena | Co dostajesz |
|---|---|---|
| Raporty Search Console | 0 zł | statystyki indeksowania, raport indeksowania stron, sprawdzanie adresów |
| Darmowa analiza SEO | 0 zł | podstawowe problemy techniczne, wynik od razu na ekranie |
| Audyt SEO | od 1 229 zł brutto | skan jak Googlebot, renderowanie, wersja mobilna, plan poprawek |
| Jednorazowa optymalizacja SEO | od 3 690 zł brutto | wdrożenie poprawek technicznych i struktury |
| Pozycjonowanie strony | od 1 190 zł brutto / mies. | stała kontrola indeksowania w ramach SEO |
Ceny brutto (zawierają 23% VAT). Audyt od 1 229 zł brutto (999 zł netto), optymalizacja od 3 690 zł brutto (3 000 zł netto). Przy dużych serwisach z analizą logów wycena jest indywidualna. Szybki przegląd podstaw zrobisz w darmowej analizie SEO.
Chcesz wiedzieć, na którym etapie Google gubi Twoje podstrony? Wycenę audytu wysyłamy w 24 h.
Wyceń audytKomu pomagamy z indeksowaniem i pracą Googlebota
Duże sklepy
Masz tysiące produktów i filtrów, a nowe produkty długo czekają na Google.
SEO sklepuStrony po migracji
Po zmianie platformy liczba zindeksowanych stron spadła.
Migracja SEOStrony oparte na JavaScript
Treść powstaje w przeglądarce i nie wiesz, czy Google ją widzi.
Aplikacje webowePortale i blogi
Publikujesz dużo i chcesz, żeby nowe artykuły szybko trafiały do wyników.
SEO blogaNowe domeny
Strona jest nowa i Google odwiedza ją rzadko.
SEO nowej stronyStrony po spadkach
Ruch spadł i szukasz przyczyny, także w indeksie.
Odzyskiwanie pozycjiCo robimy, a czego nie robimy przy indeksowaniu
Robimy
- diagnozę etapu, na którym strona odpada
- poprawki w strukturze, linkach i technice
- kontrolę raportów po wdrożeniu
- analizę logów przy dużych serwisach
Nie robimy
- masowego zgłaszania adresów w kółko
- obietnic terminu indeksacji
- sztuczek, które mają oszukać robota
- zmian bez sprawdzenia wersji mobilnej
Usługi powiązane z indeksowaniem strony w Google
Praca Googlebota to część technicznego SEO. Wybierz usługę albo napisz, a doradzimy, od czego zacząć.
Najczęstsze pytania o Googlebota i indeksowanie
Nie ma tu odpowiedzi na Twoje pytanie? Napisz albo zadzwoń, odpowiemy w ciągu 1 dnia roboczego.
Zadaj pytanieCo to jest Googlebot?
Googlebot to ogólna nazwa robota, którym wyszukiwarka Google pobiera strony internetowe. Działa w dwóch odmianach: Googlebot Smartphone, który udaje użytkownika telefonu, i Googlebot Desktop, który udaje komputer. Ponieważ Google indeksuje strony w wersji mobilnej, większość wizyt pochodzi od robota na smartfony.
Jak Google indeksuje strony?
Najpierw Googlebot odkrywa adres, zwykle z linków lub mapy witryny, potem go pobiera i renderuje jak przeglądarka. Następnie Google analizuje treść, wybiera wersję kanoniczną spośród duplikatów i decyduje, czy zapisać stronę w indeksie. Dopiero zaindeksowana strona może pojawić się w wynikach.
Ile trwa indeksowanie strony w Google?
Według pomocy Google skanowanie zgłoszonej strony może trwać od kilku dni do kilku tygodni. Nowe strony na znanych, często odwiedzanych domenach trafiają do indeksu zwykle szybciej niż strony na zupełnie nowej domenie. Żadna metoda nie gwarantuje terminu ani tego, że strona w ogóle zostanie zaindeksowana.
Co to jest crawl budget?
Crawl budget, czyli budżet indeksowania, to liczba adresów, które Google może i chce pobrać z danej strony w określonym czasie. Zależy od wydajności serwera i od tego, jak bardzo Google chce skanować stronę. Według Google ma znaczenie głównie dla dużych serwisów: od około miliona podstron zmienianych co tydzień albo od około 10 tysięcy podstron zmienianych codziennie.
Jak sprawdzić, czy to prawdziwy Googlebot?
Nagłówek user agent łatwo podrobić, więc sama nazwa Googlebot w logach niczego nie dowodzi. Prawdziwego robota rozpoznasz po odwrotnym zapytaniu DNS, które dla adresu IP zwraca domenę googlebot.com, albo po porównaniu IP z zakresami publikowanymi przez Google.
Co oznacza mobile first index?
Mobile first index oznacza, że Google ocenia i indeksuje stronę na podstawie jej wersji mobilnej. Treść, której nie ma na telefonie, może nie zostać wzięta pod uwagę, nawet jeśli jest na komputerze. Dlatego obie wersje powinny mieć tę samą treść, dane strukturalne i metatagi.
Czy Googlebot widzi treść ładowaną przez JavaScript?
Tak, Googlebot renderuje strony w aktualnej wersji Chromium i wykonuje JavaScript. Renderowanie odbywa się jednak w kolejce i nie zawsze się udaje, na przykład gdy skrypty są zablokowane albo treść pojawia się dopiero po kliknięciu. Najważniejsza treść i linki najbezpieczniej działają w HTML wysłanym przez serwer.
Ile danych Googlebot pobiera z jednej strony?
Według dokumentacji Google Search Central z lutego 2026 roku Googlebot pobiera pierwsze 2 MB pliku HTML i innych obsługiwanych formatów oraz pierwsze 64 MB pliku PDF. Pliki CSS i JavaScript pobiera osobno, każdy z tym samym limitem. Treść poza limitem nie jest brana pod uwagę przy indeksowaniu.
Ile kosztuje analiza indeksowania strony?
Samodzielnie sprawdzisz wszystko za darmo w Search Console. Jeśli chcesz, żebyśmy prześledzili drogę Googlebota po Twojej stronie, zrobimy to w audycie SEO, który kosztuje od 1 229 zł brutto. Wdrożenie poprawek to jednorazowa optymalizacja od 3 690 zł brutto albo część abonamentu pozycjonowania, a wycena przychodzi w ciągu 24 h.
Sprawdźmy, jak Google widzi Twoją stronę
Napisz, jaki adres ma strona, z ilu mniej więcej podstron się składa i które z nich nie chcą wejść do Google. Wrócimy z diagnozą wstępną i ceną w 24 h. Możesz też zadzwonić albo napisać na WhatsApp.
Napisz do nas
Odpowiadamy zwykle w ciągu jednego dnia roboczego.
Zapisz się do nowej platformy Backlink24 i odbierz 10% rabatu
Wkrótce uruchamiamy panel, w którym sam sprawdzisz swoje strony, zamówisz nowe pakiety linków i opublikujesz artykuły na portalach. Zapisani dostaną dostęp jako pierwsi i kod rabatowy na pierwsze zamówienie.
- weryfikacja stron
- zamawianie pakietów
- publikacja artykułów
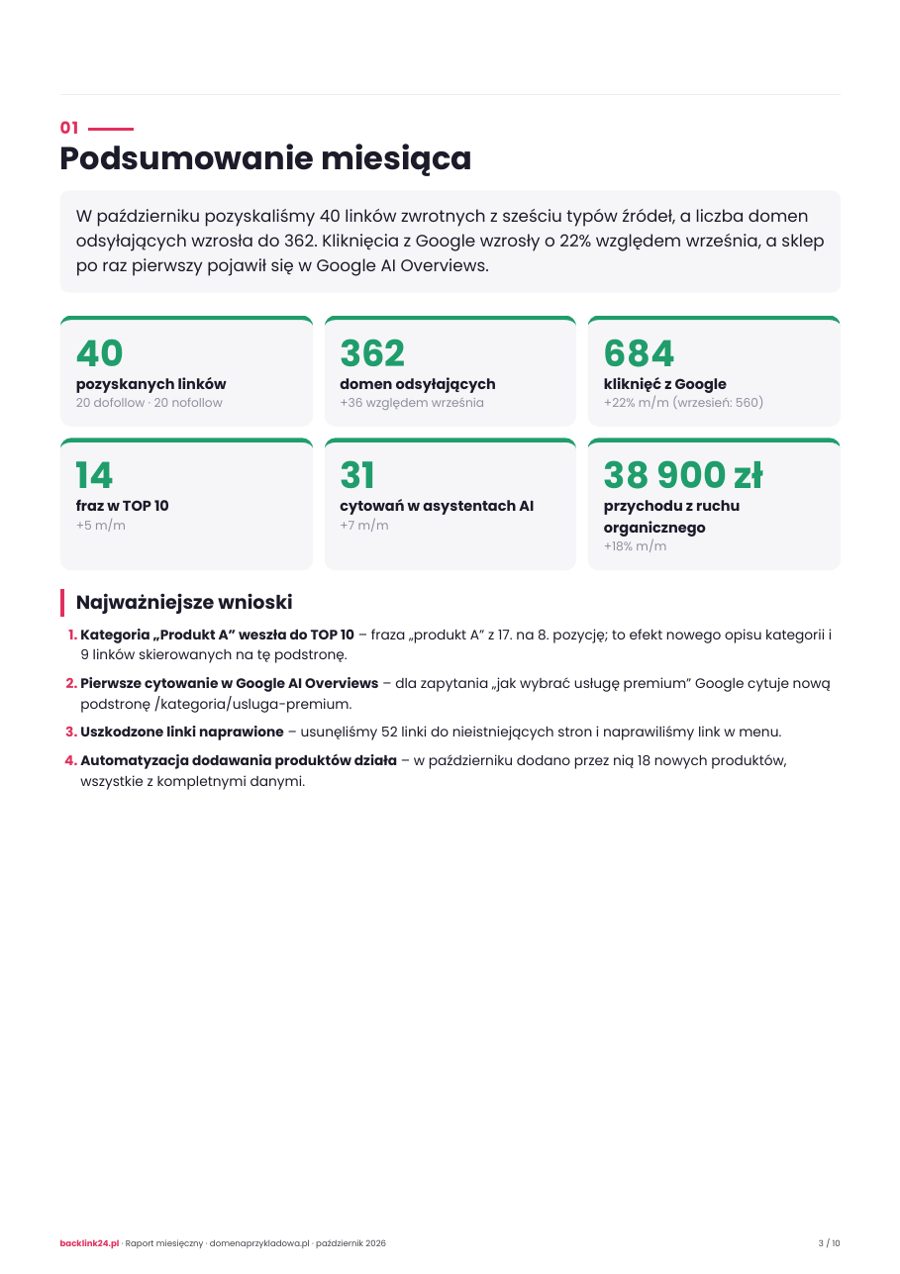
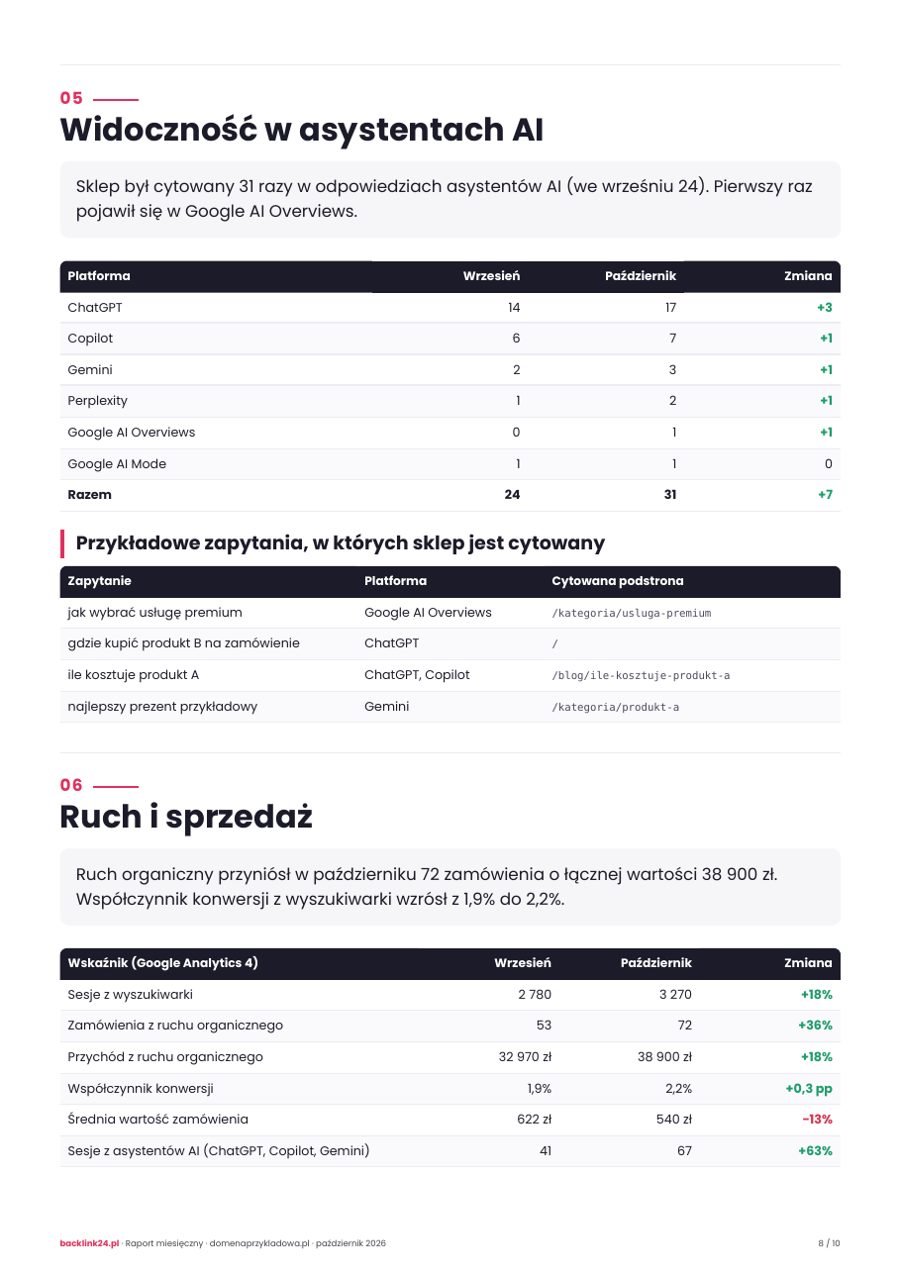
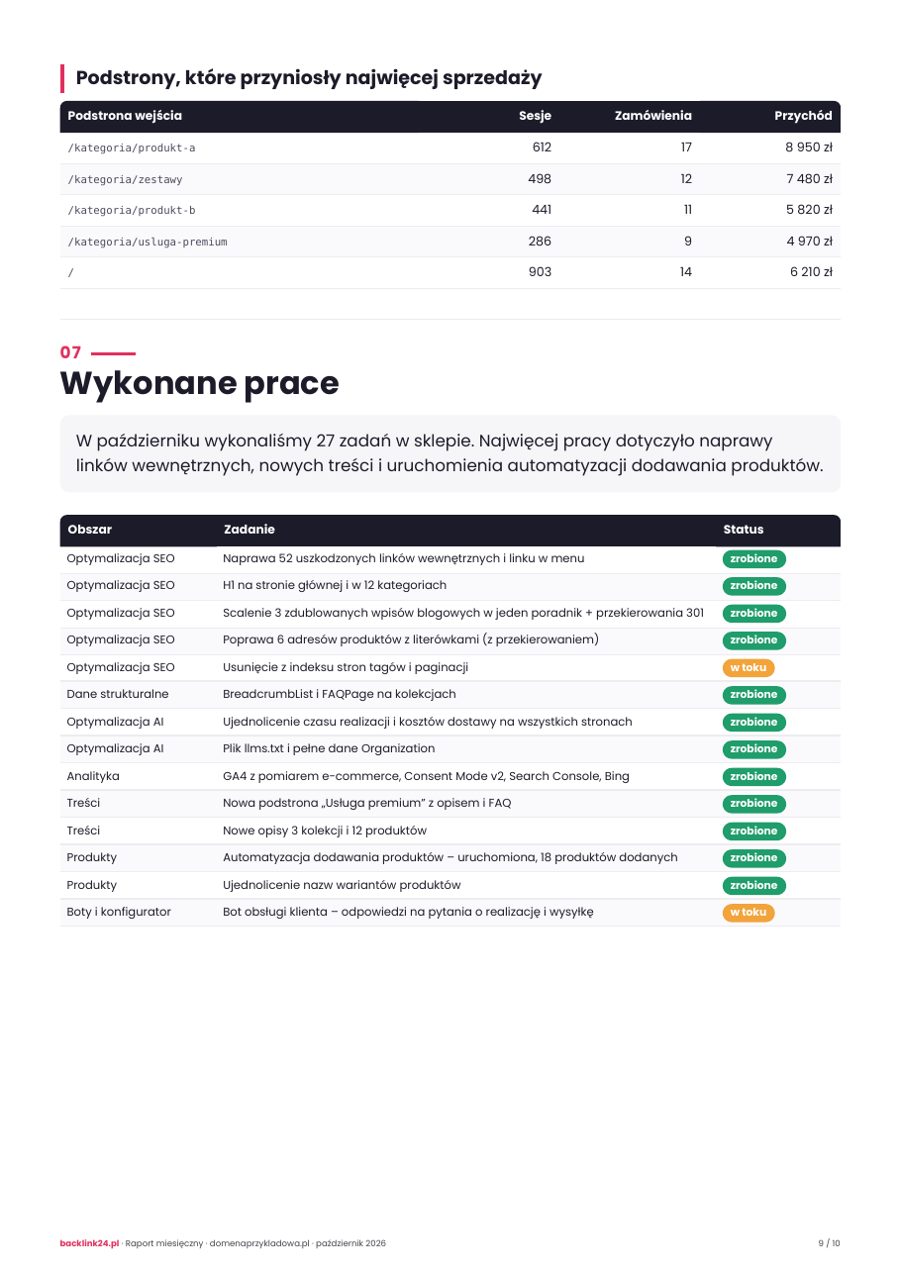
Tak wygląda raport, który dostajesz co miesiąc
Przykład na danych przykładowych: lista pozyskanych linków z adresami, widoczność w Google i w asystentach AI, ruch i sprzedaż z Google Analytics 4, wykonane prace i plan na kolejny miesiąc. Pełny raport ma 10 stron.